Présentation
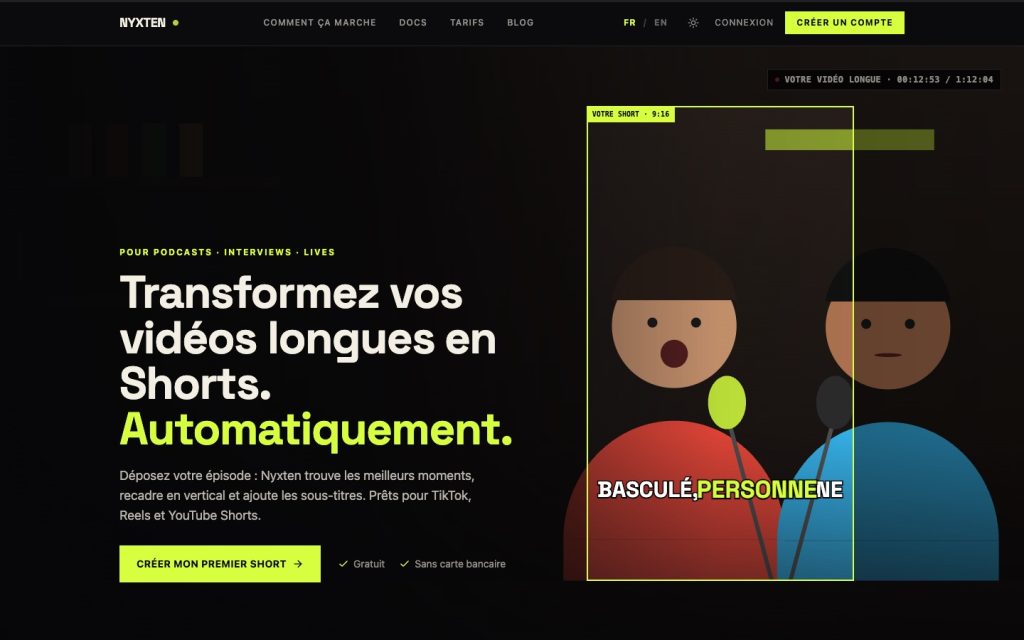
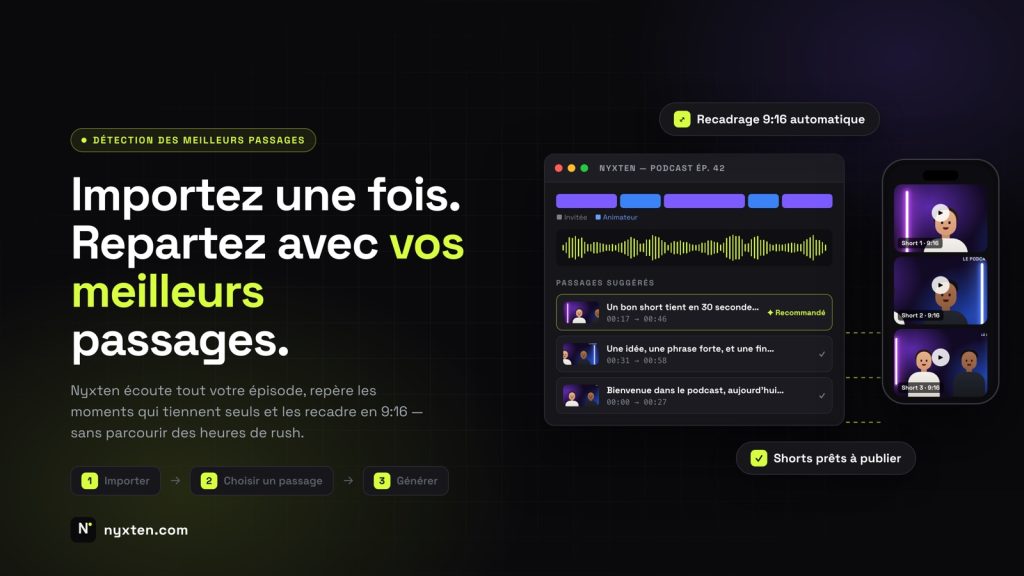
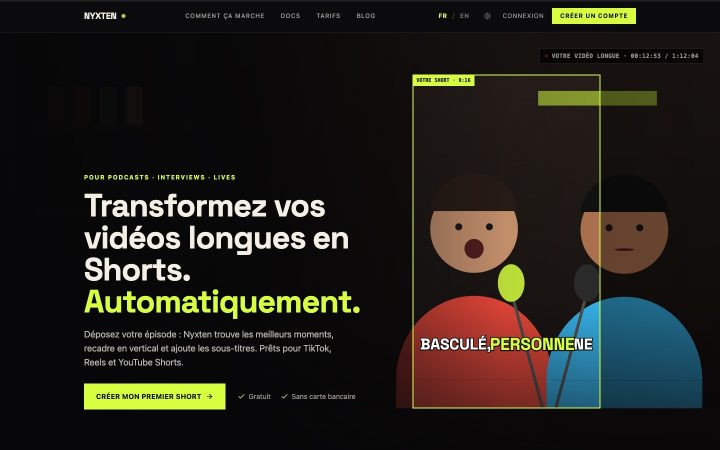
Nyxten est un service en ligne que j’ai conçu et que j’exploite : on dépose un épisode de podcast, une interview ou le replay d’un live, et l’application en extrait des Shorts verticaux sous-titrés, prêts à publier sur TikTok, Instagram Reels ou YouTube Shorts.
Le problème
Tirer quelques extraits courts d’une vidéo d’une heure demande de tout réécouter, de repérer les passages qui tiennent seuls, de recadrer en vertical puis de sous-titrer mot à mot. Plusieurs heures de montage pour une poignée de clips — c’est ce travail que Nyxten automatise.
Mon approche
Le projet a commencé comme une application locale. Dès le départ, le stockage, la file de traitement, la transcription, l’IA et le rendu vidéo ont été placés derrière des interfaces, pour pouvoir passer à un service en ligne sans réécrire le cœur métier. C’est ce qui s’est passé : Nyxten est aujourd’hui en ligne, avec comptes, crédits et paiement.
Fonctionnalités
- Transcription automatique horodatée mot à mot, corrigeable, exportable en SRT et VTT
- Détection des meilleurs passages, avec un score et la raison du choix
- Recadrage vertical 9:16, ou vidéo centrée sur fond flouté
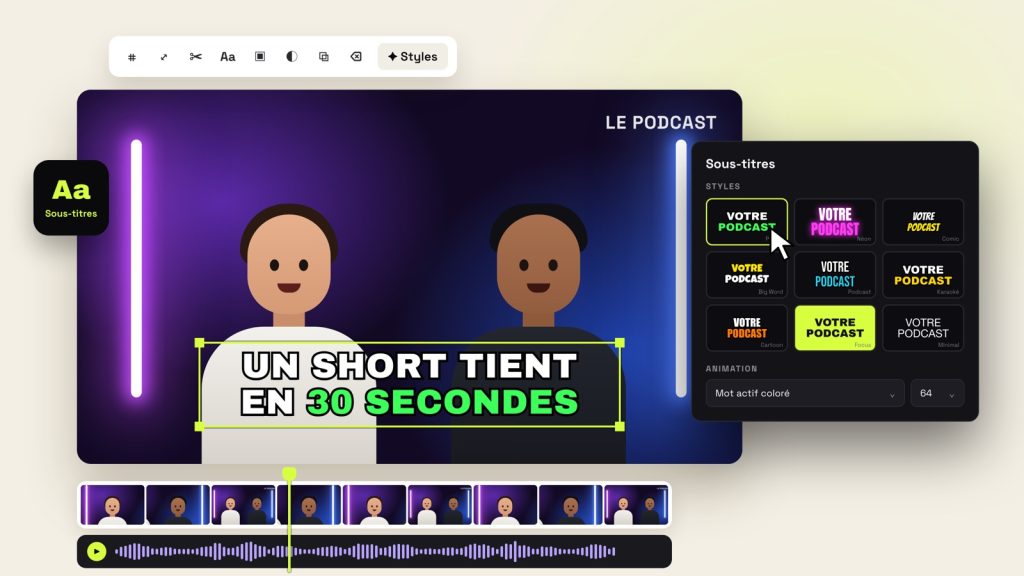
- Sous-titres animés dans plusieurs styles (karaoké, mot par mot…), personnalisables
- Traitement par lot, et variantes d’un même passage dans plusieurs styles
- Interface en français et en anglais
- Comptes (dont connexion Google), crédits et paiement Stripe
- Application installable sur mobile, avec notifications
Architecture technique
Le backend est en PHP 8.3, sans framework : API REST, routeur et migrations écrits pour le projet. Le frontend est une application Vue 3 en TypeScript, avec Pinia et Tailwind CSS. Tous les traitements lourds — import, extraction audio, transcription, rendu — passent par une file de jobs asynchrone traitée par un worker, avec nouvelles tentatives en cas d’échec : l’interface ne reste jamais bloquée pendant un rendu. La transcription repose sur whisper.cpp, le rendu sur FFmpeg avec libass pour incruster les sous-titres.
Choix techniques
L’IA est optionnelle et encadrée. La sélection des passages s’appuie d’abord sur des heuristiques locales — durée, densité du propos, phrases complètes, repérage des répétitions — qu’un modèle de langage peut ensuite affiner, avec plusieurs fournisseurs interchangeables dont un modèle local. Le modèle ne choisit que des horodatages : le texte affiché est toujours repris de la vraie transcription, jamais généré, et en cas d’échec l’application revient aux heuristiques sans rien demander à l’utilisateur.
Autre exemple : le recadrage, défini par images clés, est converti en expression FFmpeg construite uniquement à partir de valeurs numériques validées, puisqu’elle est injectée telle quelle dans la commande de rendu.
Difficultés rencontrées
Le passage d’un outil personnel à un service partagé a déplacé les problèmes. Les fichiers déposés font souvent plusieurs gigaoctets, d’où un envoi découpé en morceaux. Et une seule file de rendu sert désormais plusieurs comptes : il a fallu répartir équitablement le temps de calcul entre eux et afficher à chacun sa place dans la file, plutôt que de laisser un gros import bloquer tout le monde.
Traitements asynchrones, API, intégration de services externes : c’est le même type d’architecture que je mets en place en développement WordPress sur mesure, quand un site doit faire plus qu’afficher du contenu.